

Nelle lezioni precedenti abbiamo imparato a progettare agenti specializzati e a farli collaborare all'interno di una Crew. Abbiamo visto come suddividere un problema complesso in diversi task e come utilizzare Ollama per eseguire i nostri modelli linguistici direttamente in locale.
A questo punto possiamo fare un ulteriore passo avanti. Un sistema multi-agente, infatti, diventa molto più utile quando è in grado di ricordare informazioni, consultare una base di conoscenza e utilizzare strumenti esterni. In questa lezione vedremo proprio come aggiungere queste capacità ai nostri agenti. L'obiettivo non sarà semplicemente creare agenti capaci di generare testo, ma costruire componenti in grado di utilizzare informazioni aggiuntive durante l'esecuzione dei propri compiti.
In questo modo potremo realizzare sistemi più coerenti, contestualizzati e vicini al comportamento di un'applicazione AI reale.
Perché abbiamo bisogno della memoria?
Immaginiamo di avere un assistente AI locale che utilizziamo ogni giorno per lavorare su un progetto. Durante una prima conversazione gli spieghiamo il nome del progetto, gli obiettivi, alcune preferenze e magari anche alcune decisioni che abbiamo già preso. Se ogni nuova esecuzione della nostra applicazione partisse completamente da zero, dovremmo fornire nuovamente tutte queste informazioni. Questo renderebbe il sistema poco pratico.
La memoria serve proprio a evitare, quando necessario, che ogni interazione sia completamente indipendente dalle precedenti. In un sistema multi-agente possiamo avere informazioni che vengono ricordate e riutilizzate nel tempo. Possiamo quindi immaginare un agente che, durante una nuova attività, abbia accesso a informazioni già conosciute sul progetto, sulle precedenti interazioni o sui risultati ottenuti.
È importante però distinguere la memoria dalla knowledge base. La memoria riguarda principalmente ciò che il sistema ha appreso o utilizzato durante le proprie interazioni e attività, mentre una knowledge base rappresenta una fonte di conoscenza che possiamo fornire al sistema, come documenti, manuali, file o informazioni aziendali.
Questa distinzione ci sarà molto utile quando inizieremo a progettare applicazioni più grandi.
Memoria all'interno di CrewAI
CrewAI mette a disposizione funzionalità di memoria che permettono agli agenti e alle crew di mantenere e recuperare informazioni rilevanti. L'idea fondamentale è che possiamo lasciare che il sistema utilizzi informazioni provenienti dalle interazioni precedenti invece di affidare tutto al contesto presente nell'ultima richiesta.
Un esempio di configurazione della Crew può essere:
from crewai import Crew
crew = Crew(
    agents=[researcher, analyst, writer],
    tasks=[research_task, analysis_task, writing_task],
    memory=True,
    verbose=True
)
In questo modo abilitiamo la memoria della Crew. Naturalmente, quando utilizziamo una versione specifica di CrewAI, dobbiamo verificare la configurazione prevista dalla versione installata, perché le API possono evolvere nel tempo. La documentazione ufficiale di CrewAI rappresenta quindi il riferimento da utilizzare quando integriamo queste funzionalità nel nostro progetto.
Il concetto importante, però, rimane invariato: la memoria permette al sistema di recuperare informazioni utili provenienti dal contesto precedente.
Nelle versioni recenti di CrewAI, la memoria è diventata un vero sistema di persistenza e recupero delle informazioni. La documentazione attuale indica LanceDB come storage predefinito, con i dati salvati normalmente nella directory ./.crewai/memory del progetto (oppure in un percorso diverso se configuriamo CREWAI_STORAGE_DIR o uno storage personalizzato).
CrewAI non necessariamente legge tutte le conversazioni precedenti. Fa invece una ricerca nella memoria, individua le informazioni pertinenti e le mette a disposizione dell'agente come contesto.La memoria di CrewAI è più simile a un archivio semantico consultabile che a un semplice file contenente tutte le conversazioni.
Se vogliamo mantenere il sistema completamente locale dobbiamo fare attenzione anche al modello utilizzato per gli embedding e alla configurazione della memoria, non soltanto al modello principale di Ollama.
Memoria e workflow multi-agente
La memoria diventa particolarmente interessante quando abbiamo più agenti. Immaginiamo, per esempio, di avere un assistente composto da tre agenti: un coordinatore, un ricercatore e uno scrittore. Il coordinatore potrebbe raccogliere le preferenze dell'utente, il ricercatore occuparsi delle informazioni necessarie e lo scrittore utilizzare sia i risultati della ricerca sia le preferenze già conosciute.
Possiamo quindi avere un flusso simile:
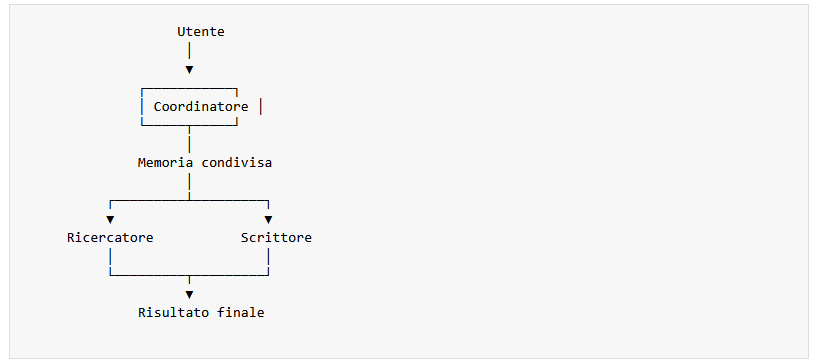
La memoria non sostituisce il contesto dei task. Sono due concetti differenti. Il context ci permette di passare esplicitamente il risultato di un'attività a un'altra. La memoria, invece, ci permette di recuperare informazioni che possono provenire da interazioni o attività precedenti. Questa differenza diventa fondamentale quando il nostro progetto cresce.
Che cos'è una Knowledge Base?
Passiamo ora alla knowledge base. Possiamo considerarla come una fonte di conoscenza a disposizione dei nostri agenti. Invece di chiedere al modello di rispondere esclusivamente sulla base delle informazioni contenute nei suoi parametri, possiamo permettergli di consultare documenti e contenuti specifici del nostro progetto.
Supponiamo di voler creare un assistente AI per un'azienda. Potremmo avere:
knowledge/
├── azienda.txt
├── prodotti.txt
├── assistenza.txt
├── procedure.txt
└── faq.txt
Questi file potrebbero contenere informazioni che il nostro modello locale non conosce.
Se chiedessimo direttamente a Ollama:
Qual è la procedura interna per richiedere un rimborso?
il modello potrebbe non avere alcuna informazione specifica sull'azienda. Se invece gli permettiamo di consultare la nostra knowledge base, possiamo recuperare il documento corretto e utilizzare il contenuto come contesto per generare la risposta.
Questo approccio è alla base di molte applicazioni moderne di Retrieval-Augmented Generation, spesso abbreviato in RAG.
Possiamo iniziare con un esempio molto semplice utilizzando un file locale. Supponiamo di avere azienda.txt:
from crewai import Agent, LLM
llm = LLM(
    model="ollama/llama3.2",
    base_url="http://localhost:11434"
)
assistant = Agent(
    role="Assistente aziendale",
    goal="Rispondere alle domande utilizzando le informazioni disponibili",
    backstory=(
        "Siamo un assistente aziendale. "
        "Dobbiamo fornire risposte precise e non inventare informazioni."
    ),
    llm=llm,
    verbose=True
)
A questo punto possiamo leggere il contenuto del file e inserirlo nel task:
with open("knowledge/azienda.txt", "r", encoding="utf-8") as file:
    knowledge = file.read()
task = Task(
    description=(
        "Rispondere alla domanda dell'utente utilizzando esclusivamente "
        "le informazioni contenute nella seguente knowledge base:\n\n"
        f"{knowledge}\n\n"
        "Domanda: {question}"
    ),
    expected_output="Una risposta precisa e comprensibile.",
    agent=assistant
)
Infine possiamo creare la Crew:
crew = Crew(
    agents=[assistant],
    tasks=[task],
    verbose=True
)
result = crew.kickoff(
    inputs={
        "question": "Quando è disponibile il servizio di assistenza?"
    }
)
print(result)
In questo esempio abbiamo utilizzato una soluzione molto semplice. Abbiamo letto il documento e inserito direttamente il contenuto nel prompt. È utile per comprendere il concetto, ma non è una soluzione ideale quando disponiamo di centinaia o migliaia di documenti.
In un sistema reale abbiamo bisogno di un meccanismo più efficiente per cercare solamente le informazioni rilevanti
Conclusioni
In questa lezione abbiamo introdotto due elementi fondamentali per rendere i nostri sistemi multi-agente più completi: la memoria e la Knowledge Base. Abbiamo visto come CrewAI possa mantenere e recuperare informazioni utili nel tempo e come possiamo fornire ai nostri agenti una fonte di conoscenza specifica attraverso documenti e contenuti locali.
Nella prossima lezione ci concentreremo invece sull'integrazione degli strumenti, imparando a permettere ai nostri agenti di interagire con file, servizi e risorse esterne, aumentando così le loro capacità operative e il livello di autonomia del nostro sistema.
Se vuoi aggiornamenti su Memoria e Knowledge Base inserisci la tua email nel box qui sotto:
