

In questa lezione ci occuperemo di approfondire le potenzialità di Claude Vision applicate alla classificazione delle immagini. Attraverso un approccio guidato, vedremo come possiamo utilizzare il modello non soltanto per interpretare contenuti visivi, ma anche per organizzarli in categorie predefinite in modo rapido ed efficace. L’obiettivo che ci poniamo è comprendere come sfruttare le capacità multimodali di Claude per risolvere un problema pratico di riconoscimento e classificazione, fornendo così uno strumento utile in contesti reali come l’e-commerce, la gestione documentale o l’analisi di dataset visivi.
Cos'è Claude Vision
Quando parliamo di Claude Vision ci riferiamo alla capacità dei modelli Claude più recenti di elaborare non soltanto testo, ma anche contenuti visivi. In altre parole, noi possiamo fornire a Claude un’immagine, che si tratti di una fotografia, di un grafico, di uno screenshot o di un documento, e chiedergli di analizzarla, descriverla, estrarne informazioni o classificarla.
Questa funzionalità rende il modello multimodale, perché combina il linguaggio naturale con la comprensione visiva, permettendoci di affrontare una gamma molto più ampia di casi d’uso concreti. Il modello che Claude utilizza per il riconoscimento delle immagini si basa su un’architettura che integra l’elaborazione del linguaggio naturale con la visione artificiale. In pratica, Claude Vision estende un modello di tipo LLM (Large Language Model) in grado di gestire input sia testuali che visivi, trasformando le immagini in rappresentazioni numeriche interne che permettono di comprendere forme, colori, testi presenti e il contesto dell’immagine.
Grazie a questa combinazione, il modello può fare inferenze contestuali, come classificare un oggetto, descrivere un grafico o riconoscere elementi specifici in un documento.
Il caso d’uso: classificare le immagini con Claude Vision
Per rendere più concreto l’apprendimento di Vision, ci concentreremo su un caso d’uso specifico: la classificazione di immagini. L’idea è quella di fornire a Claude Vision una serie di immagini e chiedergli di assegnarle a categorie predefinite, come avviene per esempio nel settore dell’e-commerce, dove i prodotti devono essere suddivisi in tipologie quali scarpe, borse o accessori. Questo approccio ci permette di osservare come Claude non si limiti a descrivere ciò che vede, ma sia in grado di interpretare il contenuto visivo alla luce di regole e insiemi di etichette da noi stabiliti, facilitando così la gestione e l’organizzazione dei dati.
Come realizziamo la classificazione passo dopo passo
Per comprendere meglio il funzionamento di Claude Vision, procediamo con un esempio pratico in cui classifichiamo immagini di prodotti. I passaggi fondamentali sono i seguenti:
- Definizione delle categorie. Stabiliamo in anticipo un insieme chiaro di classi, ad esempio: Scarpe, Borse e Accessori. Questo aiuta il modello a limitare le possibilità e a rispondere in modo coerente.
- Caricamento dell’immagine. Inseriamo nella chat di Claude (oppure tramite API) un'immagine del prodotto che desideriamo classificare.
- Prompt di classificazione. Formuliamo una richiesta diretta, come: “Classifica questa immagine in una delle seguenti categorie: Scarpe, Borse, Accessori. Rispondi solo con la categoria corretta.”
- Analisi del modello. Claude Vision elabora l’immagine, riconosce gli elementi visivi rilevanti (forma, materiali, contesto) e li confronta con le categorie fornite.
- Restituzione del risultato. L’output è la categoria corrispondente, ad esempio:
- Per un’immagine di sneakers delle Scarpe.
- Per una foto di una borsa a tracolla delle Borse
In questo modo, otteniamo una classificazione rapida e coerente, senza la necessità di addestrare da zero un modello di machine learning dedicato.
Come usare Vision
Possiamo utilizzare le capacità di visione di Claude tramite:
- claude.ai. Carichiamo un’immagine come faremmo con un file, oppure trasciniamo direttamente l’immagine nella finestra della chat.
- Richiesta API. Possiamo inviare immagini attraverso le API, come mostrato nell'esempio in basso in questa lezione.
Usare Vision su claude.ai
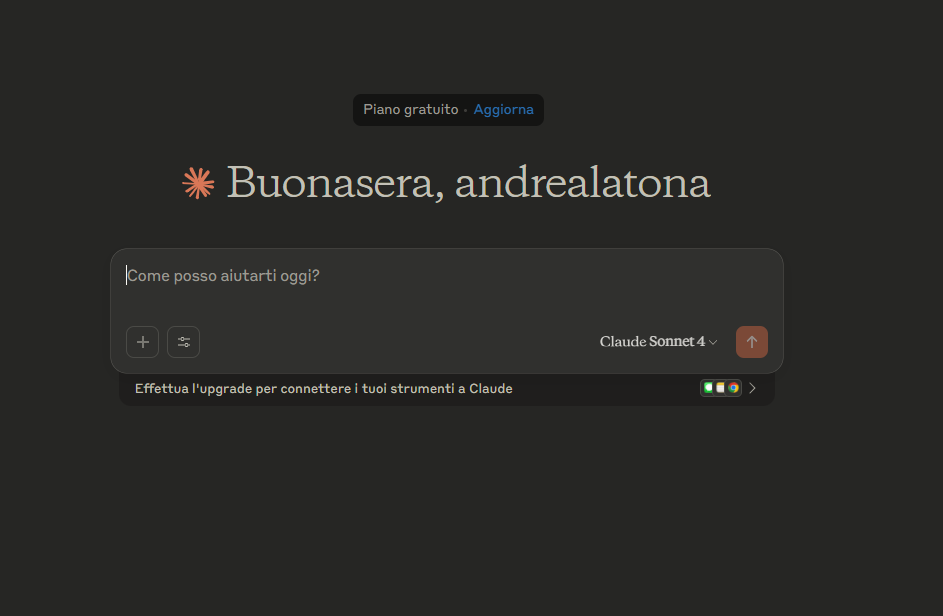
Su claude.ai possiamo utilizzare le sue capacità di visione in modo semplice e immediato: è sufficiente avviare una chat con un modello che supporta Vision (da Claude 3 in poi), quindi caricare un’immagine come se fosse un file oppure trascinarla direttamente nella finestra della conversazione; a questo punto accompagniamo l’immagine con un prompt testuale che specifichi cosa vogliamo ottenere, ad esempio:
guarda questa immagine e dimmi se si tratta di una scarpa, di una borsa o di un accessorio
Il modello analizzerà il contenuto visivo restituendoci una risposta coerente con le nostre istruzioni.
Questo approccio è ideale quando desideriamo testare rapidamente un’idea o sperimentare casi d’uso didattici senza dover scrivere codice o configurare un ambiente tecnico. Adesso, salviamo questa immagine e carichiamola su Claude, trascinandola nello spazio dedicato alla scrittura dei prompt, come mostrato in basso.

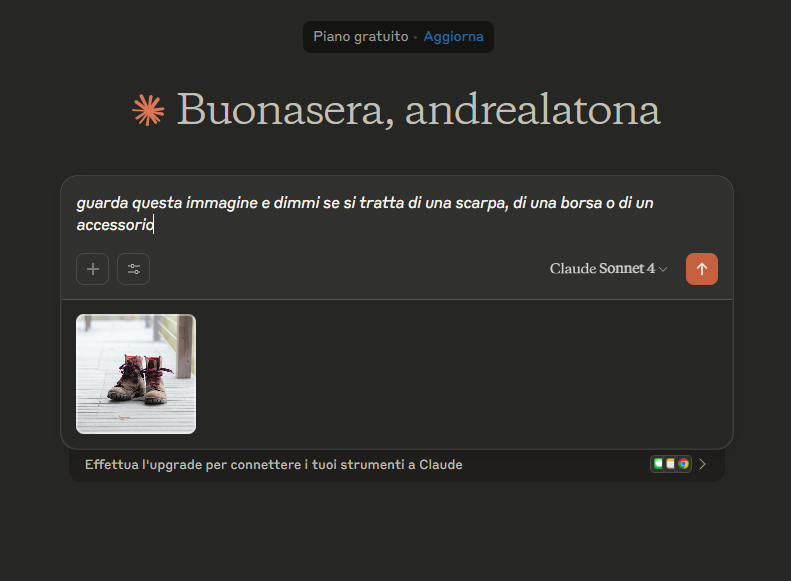
Quello che Claude ci rispondera sarà:
Guardando l'immagine, si tratta chiaramente di scarpe - nello specifico, un paio di scarponcini da trekking o hiking boots. Sono scarpe alte alla caviglia, di colore marrone/beige con lacci rossi, appoggiate su una superficie di legno (sembra un ponte o una veranda). Hanno l'aspetto di calzature robuste pensate per attività all'aperto.
Usiamo le API
Per sfruttare le capacità di Claude Vision tramite API, possiamo inviare richieste che includono sia il testo della nostra istruzione sia l’immagine codificata in base64. Questo metodo ci permette di integrare l’analisi visiva in applicazioni e flussi automatizzati, ottenendo classificazioni o descrizioni strutturate direttamente dal modello. È importante sottolineare che l’uso delle API è a pagamento, quindi dobbiamo tener conto dei costi associati a ogni richiesta, soprattutto quando si elaborano grandi quantità di immagini.
Ecco un esempio pratico in Python per caricare un’immagine e inviarla alle API di Claude:
import base64
from anthropic import Anthropic
# Inizializziamo il client con la nostra API key
client = Anthropic(api_key="LA_NOSTRA_API_KEY_CHE OTTERREMO_DOPO_PAGAMENTO_DEI_TOKEN")
# Apriamo l'immagine da inviare
with open("scarpe.jpg", "rb") as f:
    image_bytes = f.read()
# Creiamo la richiesta al modello Claude Vision
response = client.messages.create(
    model="claude-sonnet-4-20250514",
    max_tokens=1024,
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "text",
                    "text": "Classifica questa immagine in una delle categorie: Scarpe, Borse, Accessori. Rispondi solo con la categoria."
                },
                {
                    "type": "image",
                    "source": {
                        "type": "base64",
                        "media_type": "image/jpeg",
                        "data": base64.b64encode(image_bytes).decode("utf-8"),
                    },
                },
            ],
        }
    ],
)
# Stampiamo il risultato restituito da Claude
print(response.content[0].text)
Conclusione
Le API di Claude Vision ci consentono di automatizzare completamente il processo di classificazione delle immagini, integrando l’analisi visiva direttamente nei nostri flussi di lavoro o nelle applicazioni. Questa possibilità ci permette di gestire grandi volumi di dati visivi in modo rapido ed efficiente, riducendo l’intervento manuale e aumentando la coerenza dei risultati. È però importante ricordare che l’utilizzo delle API è a pagamento, quindi dobbiamo considerare i costi associati all’elaborazione di ogni richiesta quando pianifichiamo la scalabilità del nostro sistema.
Se vuoi aggiornamenti su Analisi di immagini con Claude Vision inserisci la tua email nel box qui sotto:
